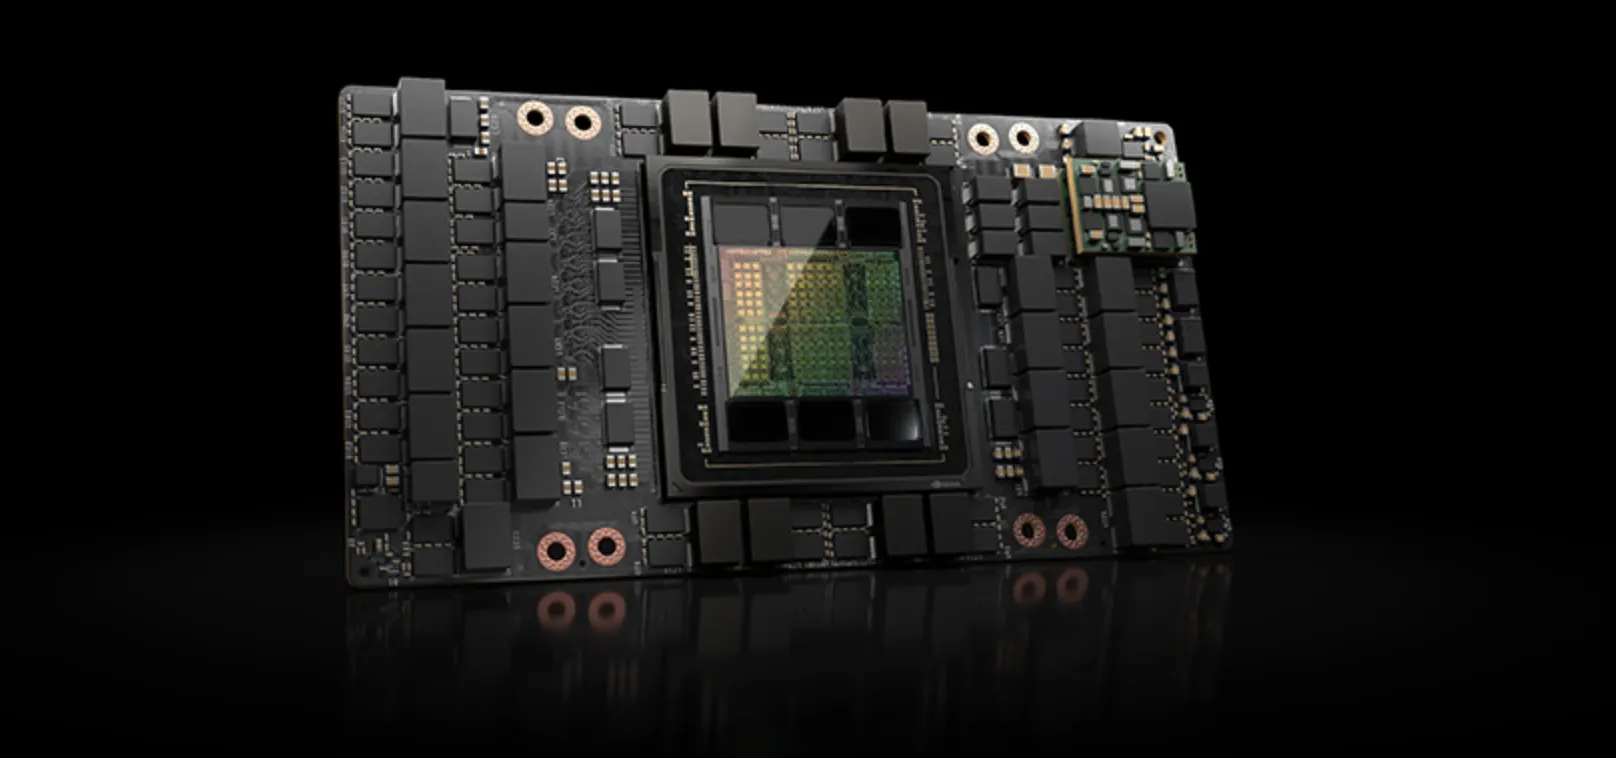
H100
Hopper · 基準款
- 記憶體
- 80 GB HBM3
- 推理效能
- 1.0×(基準)
主力款 GPU,適合一般 LLM 與多模態推理,是大多數正式環境工作負載的起點。
Prime Inference 提供專屬的單一租戶 GPU、針對開源或你自有模型調校的執行環境,以及協助你從原型走到正式環境 SLA 的 GMI 工程團隊。
H200 · B300 · Blackwell
NVIDIA 認證硬體
99.9% 可用性*
正式環境 SLA
我們在 Prime Inference 預留 GPU 上對最新的開源模型進行了基準測試 — 於 B200、B300 與 GB200 NVL72 上採用針對每個模型調校的執行環境。在持續負載下,專屬端點以不到無伺服器(MaaS)定價一半的成本處理相同的 token 量,同時提供單一租戶隔離、無冷啟動與可預期的延遲。
~35%
專屬部署與無伺服器打平的持續使用率 — 超過之後,每個 token 都更便宜
最高 5.6 倍
滿載使用時,相較於無伺服器定價每美元可得的 token 數(DeepSeek V4 Pro)
GPU 滿載下的有效成本,輸入 8K / 輸出 1K,FP4
無伺服器定價
$1.13
專屬 · B200
$0.40
Dynamo + vLLM
-56%專屬 · GB200 NVL72
$0.20
Dynamo + SGLang, multi-node
-82%無伺服器定價
$0.98
專屬 · B200
$0.43
SGLang, FP4
-56%專屬 · GB200 NVL72
$0.20
Dynamo + SGLang, multi-node
-80%無伺服器定價*
$1.01
專屬 · H200 node**
$0.46
無伺服器(MaaS)定價
Prime Inference — 單一節點
Prime Inference — GB200 NVL72 橫向擴展
測試方法:每個請求輸入 8K / 輸出 1K token,FP4 精度(H200 為 FP8),滿載的預留 GPU,並排除閒置時間。專屬成本 = 在 Prime Inference 預留容量上持續滿載時,每 100 萬 token 的有效美元成本。無伺服器基準 = 同一模型的 GMI Cloud MaaS 定價;Kimi K2.7 Code 則採用公開的無伺服器定價(輸入 $0.70/M、輸出 $3.50/M)依 8K/1K 工作負載混算。Kimi K2.7 Code 的數據來自單一 8× H200 節點的實際生產部署量測。你的損益平衡點取決於流量型態 — 歡迎與我們聯繫,我們會依你實際的 token 用量進行試算。
預留容量能直接呼應實際的正式環境流量,而針對每個模型的執行階段最佳化更會隨著時間持續累積優勢。
不是通用堆疊,而是針對每個模型最佳化的核心、排程與路由。你只需選擇模型,引擎部分交給我們處理。
預留 GPU 會預先載入權重並維持暖機狀態,每一次呼叫都能立即執行 — 沒有冷啟動延遲,也沒有首個 token 的抖動。
GPU 完全保留給你的工作負載。沒有吵雜的鄰居、沒有負載下的競用,也不會有共用方案常見的意外狀況。
支援任何開源、微調或自有權重。可從 Hugging Face、S3 或自己的儲存空間載入,並執行於專為服務該模型而打造的執行階段上。
我們的推理工程師會持續調校最常被部署的開源模型背後的執行階段 — 當你選好模型時,核心層的最佳化工作其實已經完成。
vLLM、TensorRT-LLM 與 SGLang 已依不同 GPU 等級預先調校。量化可彈性設定,多 GPU 編排也由我們處理。
可將端點釘選在指定區域以降低首個 token 延遲,或鎖定區域以符合資料駐留要求。
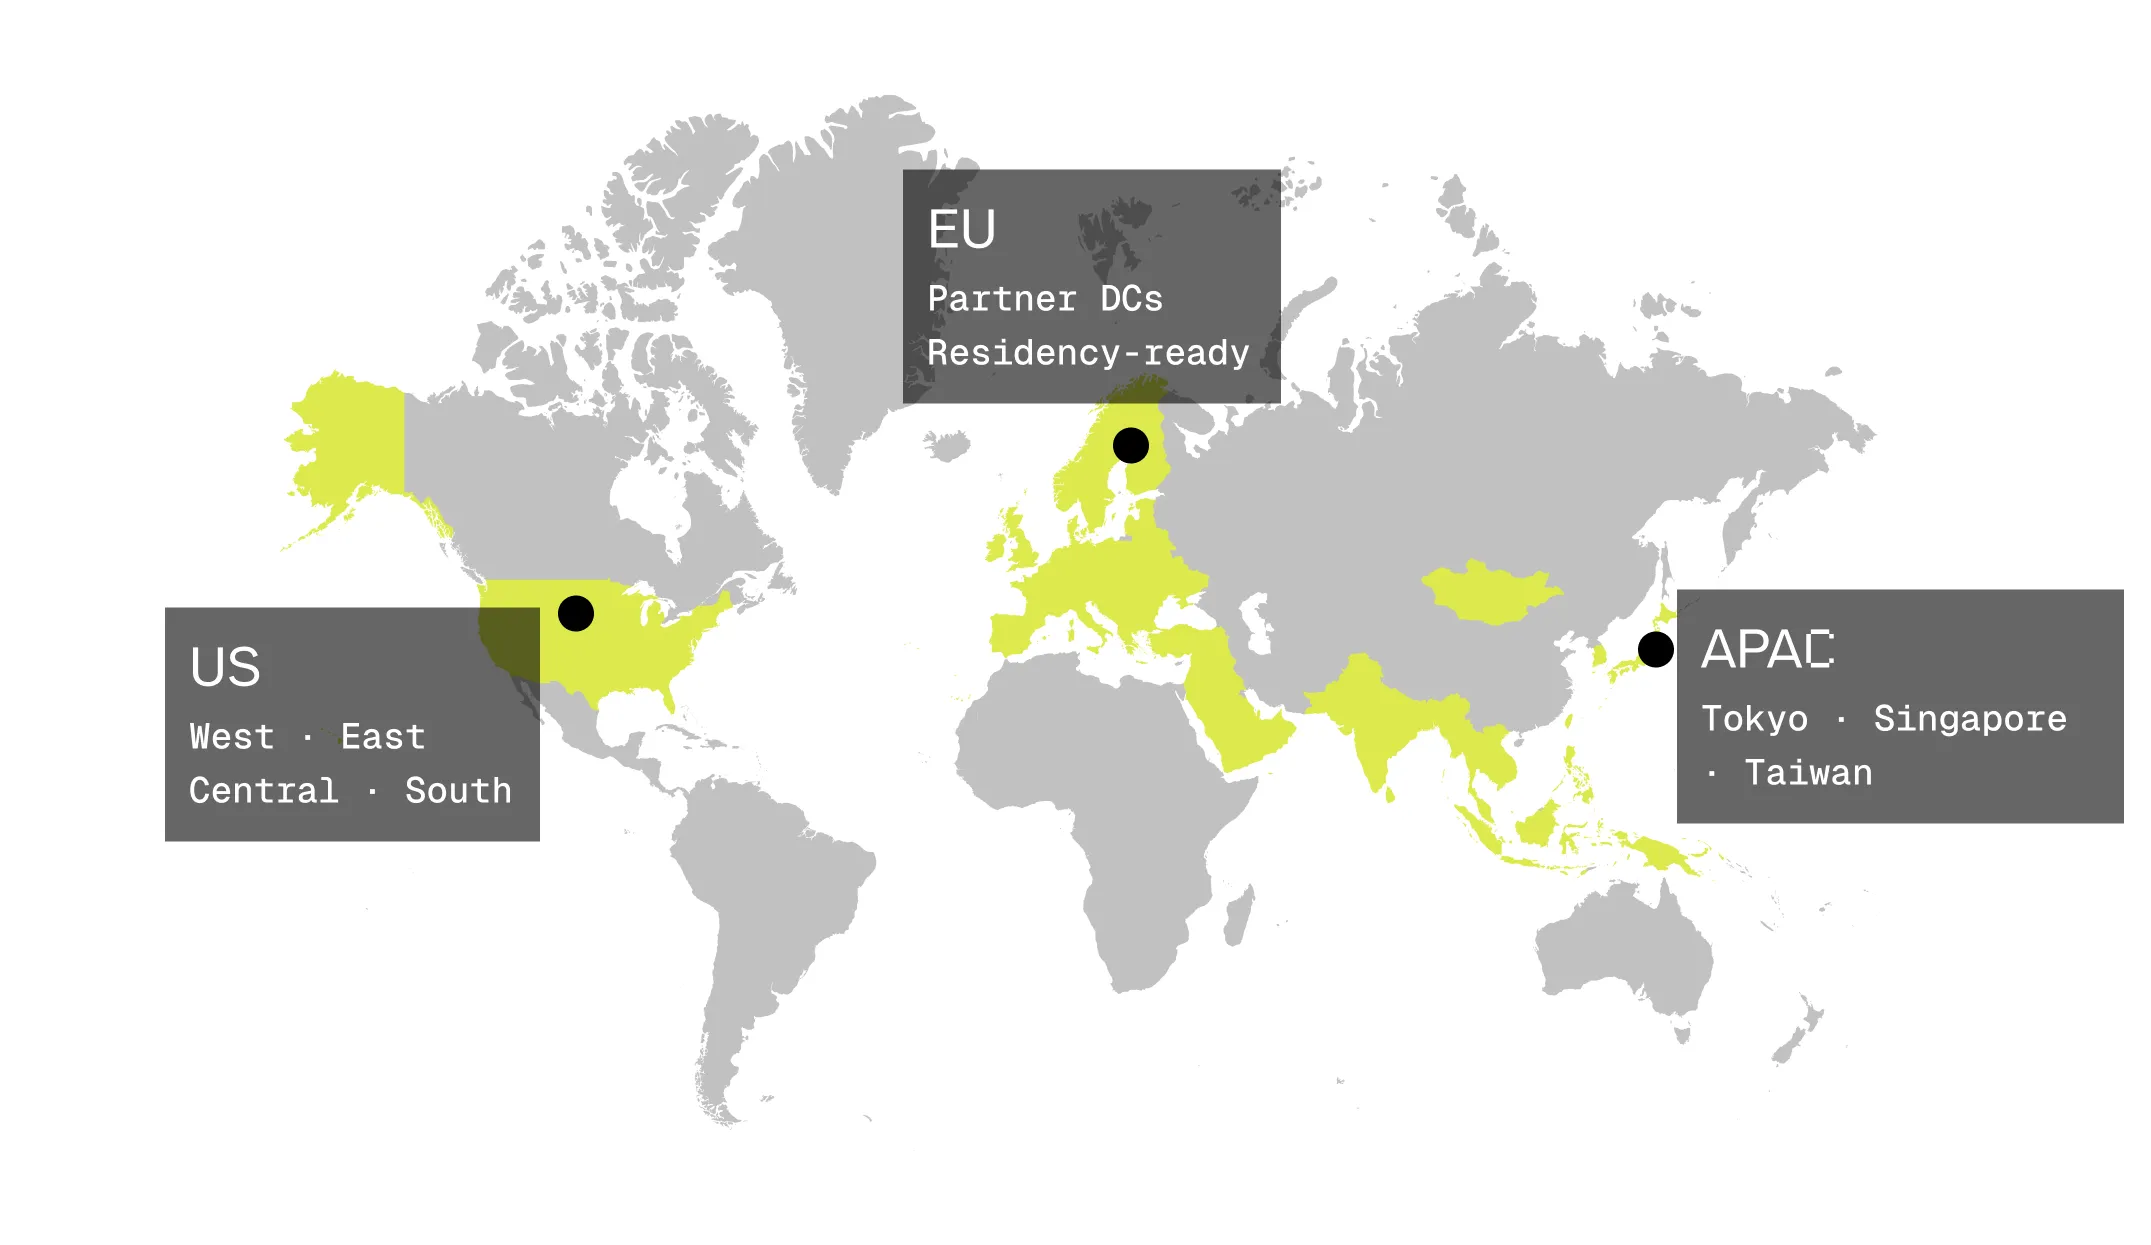
東京 · 新加坡 · 台灣 — 服務成長最快速的 AI 市場。
美國西部、東部、中部與南部 — 適合高吞吐量的正式環境流量。
歐盟合作夥伴資料中心 — 服務具備資料駐留與法遵需求的工作負載。
在你需要穩定效能時提供預留容量;需求突增時提供突發容量;流量下降時自動收縮。你只需為實際使用的部分付費。
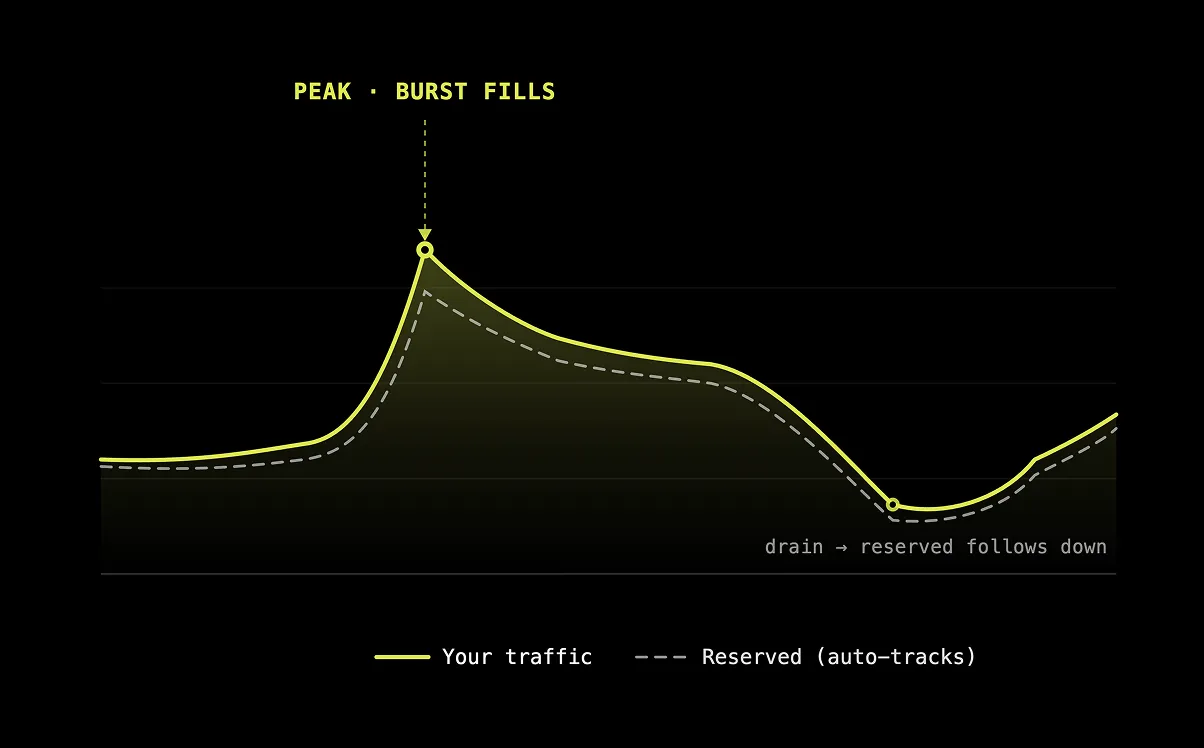
尖峰流量會自動被吸收,不會有排隊、不需要手動擴展,也不會在展示或產品上線時失敗。
離峰時段成本更低。容量會在不中斷進行中的請求的情況下平順縮減。
當主要區域容量達到上限時,流量可從最近的鄰近區域借用容量,維持低延遲與服務不中斷。
選好模型、選好硬體,然後部署。平台會處理模型載入、資源編排與路由 — 從選擇到實際可用的 API,整個過程只要幾分鐘。
任何開源模型、Hugging Face 上的模型,或上傳你自己的權重皆可。
選擇 GPU 類型、每個複本的 GPU 數量、複本數量與目標區域。
可從控制台、CLI 或 API 啟動。端點在幾分鐘內就會上線,不必等好幾天。
監控延遲與吞吐量。流量增加時自動突發、減少時自動收縮。
一鍵部署主流開源模型 — DeepSeek、Kimi、GLM、Llama、NVIDIA 等等。從尖端 LLM 到視覺、語音與多模態 — 選好模型,就能取得正式環境端點。
deepseek-ai
moonshot-ai
z-ai
meta-llama
nvidia
在這些正式環境流量場景中,可預期性、吞吐量與工程協作能將可運作的原型轉變為穩定可靠的產品。
每個任務都會有許多短請求,使用者體驗主要取決於第一次呼叫的延遲。工具呼叫必須穩定,而不只是要求快。
每個代理叢集都有穩定端點 · 暖機容量 · 展示或產品上線時也不會冷啟動。
語音場景無法容忍效能波動。需要持續性的 WebSocket 連線搭配暖機容量,並透過區域釘選縮短往返時間。
首位元組 TTS 低於一秒 · 串流端點 · 不會出現共用方案常見的抖動。
以硬體可承受的吞吐量支撐每日數百萬次查詢,並在長上下文工作負載中維持一致的尾端延遲。
KV-cache 已最佳化 · P95/P99 可控 · 沒有共用資源池的競用。
提供隔離的執行階段、稽核日誌與不留存的服務模式。可區域鎖定,適用於金融、醫療與公部門。
支援歐盟資料駐留 · 單一租戶隔離 · 企業級 SLA。
Hopper、Hopper-refresh、Blackwell 與 Blackwell Ultra — 可依記憶體需求、上下文長度或前沿效能需求做選擇。
Hopper · 基準款
主力款 GPU,適合一般 LLM 與多模態推理,是大多數正式環境工作負載的起點。
Hopper 改版
適合記憶體密集型工作負載 — 長上下文、大型 KV-cache、大批次處理。
Blackwell · 前沿款
適合前沿模型、FP4 推理與最高吞吐量需求,是對效能要求極高工作負載的首選。
Blackwell Ultra · 前沿加強款
單張 GPU 記憶體最大,專為兆級參數模型、超長上下文與最高吞吐量的 FP4 推理打造 — 當 B200 還不夠時的選擇。
PRIME INFERENCE · 專屬
預留的單一租戶 GPU — 沒有吵鬧鄰居,也沒有冷啟動
針對每個模型調校的執行環境:每張 GPU 最高 500K TPM(每分鐘 token 數)
使用率越高,每個 token 的成本越低 — 每美元最多可得 5.6 倍的 token
99.9%* 可用性 SLA,延遲可預期
支援自訂與微調模型部署
多區域**:APAC、北美、歐洲
無伺服器 (MAAS)
依 token 計費,無需承諾用量
即開即用 — 適合原型開發與評估
共用容量:吞吐量與延遲會隨平台負載變動
無論擴展到多大規模,定價都維持不變
持續使用率超過 ~35-45% 之後,會比專屬部署更貴
常見問題
從控制台啟動 Prime Inference 端點 — 或聯絡銷售團隊,瞭解預留容量、客製化調校與試用額度。