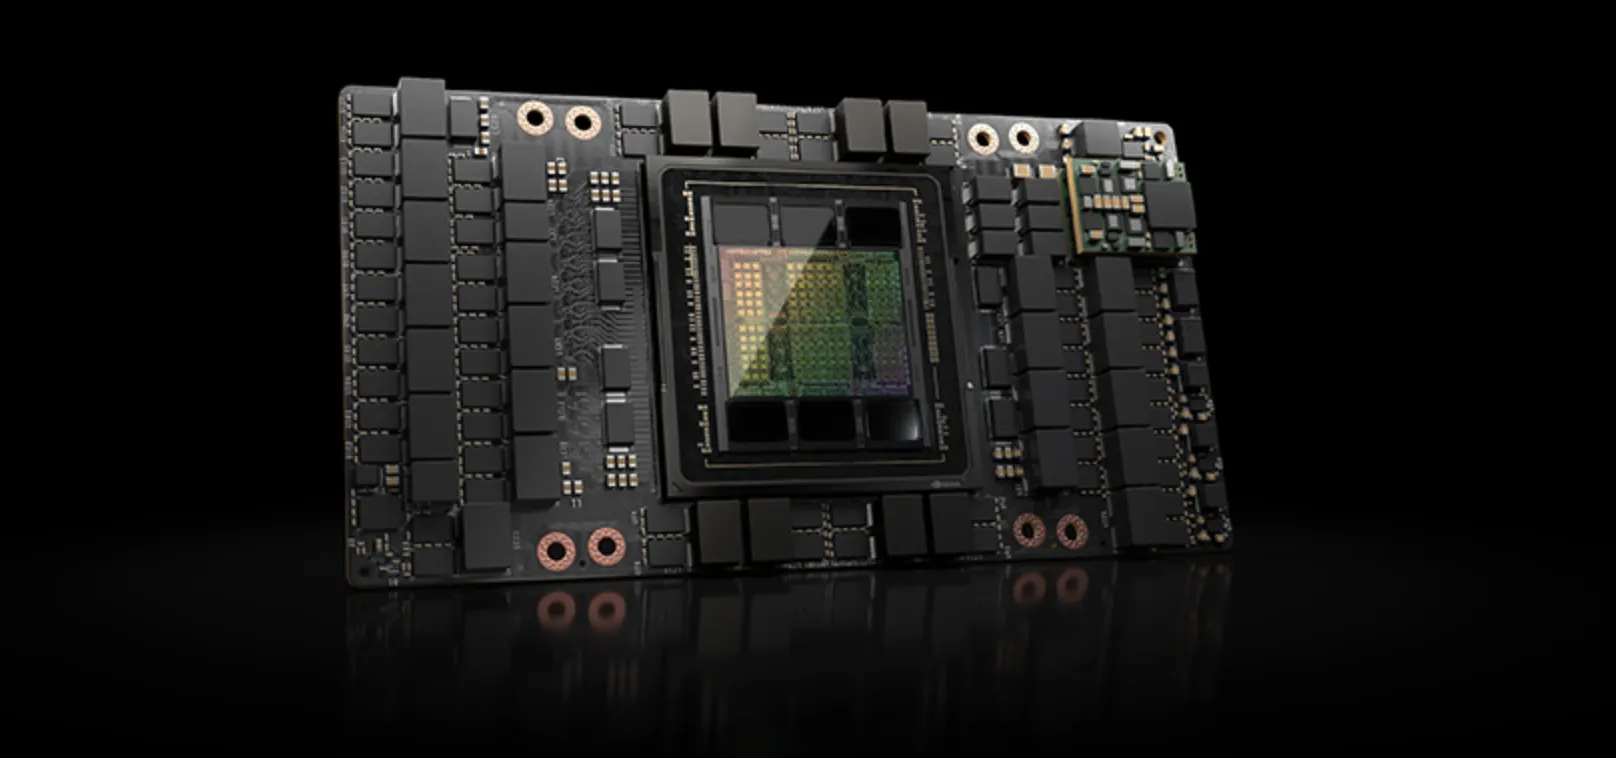
H100
Hopper · ベースライン
- メモリ
- 80 GB HBM3
- 推論性能
- 1.0×(ベースライン)
主力モデル。汎用 LLM とマルチモーダル推論向け。ほとんどの本番ワークロードはここから始まります。
Prime Inference は、専有のシングルテナント GPU、オープンソースモデルにもお客様独自のモデルにも合わせて最適化したランタイム、そしてプロトタイプから本番 SLA まで伴走する GMI のエンジニアリングチームを提供します。
H200 · B300 · Blackwell
NVIDIA 認定ハードウェア
99.9% 稼働率*
本番 SLA
Prime Inference の予約 GPU 上で最新のオープンモデルをベンチマークしました — B200、B300、GB200 NVL72 でモデルごとにチューニングしたランタイムを使用しています。持続的な負荷では、専有エンドポイントはサーバーレス (MaaS) の定価の半分未満で同じトークン数を処理し、シングルテナントの分離、コールドスタートなし、予測可能なレイテンシを実現します。
~35%
専有がサーバーレスと損益分岐する持続的な稼働率 — これを超えると、すべてのトークンがより安価になります
最大 5.6 倍
フル稼働時のサーバーレス定価と比較した 1 ドルあたりのトークン数 (DeepSeek V4 Pro)
GPU フル稼働時の実効コスト、入力 8K / 出力 1K、FP4
サーバーレス定価
$1.13
専有 · B200
$0.40
Dynamo + vLLM
-56%専有 · GB200 NVL72
$0.20
Dynamo + SGLang, multi-node
-82%サーバーレス定価
$0.98
専有 · B200
$0.43
SGLang, FP4
-56%専有 · GB200 NVL72
$0.20
Dynamo + SGLang, multi-node
-80%サーバーレス定価*
$1.01
専有 · H200 node**
$0.46
サーバーレス (MaaS) 定価
Prime Inference — シングルノード
Prime Inference — GB200 NVL72 スケールアウト
メソドロジー: リクエストあたり入力 8K / 出力 1K トークン、FP4 精度 (H200 では FP8)、フル稼働の予約 GPU、アイドル時間は除外。専有コスト = Prime Inference の予約キャパシティで持続的にフル稼働した場合の 100 万トークンあたりの実効ドル。サーバーレス基準 = 同一モデルの GMI Cloud MaaS 定価。Kimi K2.7 Code については、公開されているサーバーレス定価 (入力 $0.70/M、出力 $3.50/M) を 8K/1K のワークロードでブレンドしています。Kimi K2.7 Code の数値は、8× H200 ノード 1 台での実稼働デプロイメントから測定しています。損益分岐点はトラフィックの形状によって異なります — ご相談いただければ、実際のトークン量に基づいて試算します。
予約済み容量は実際の本番トラフィックに報い、モデルごとのランタイム最適化が時間とともにその優位性を積み重ねます。
汎用スタックではなく、モデルごとのカーネル、スケジューリング、ルーティング最適化。モデルを選べば、エンジン部分は私たちが担当します。
予約済み GPU は重みをプリロードしてウォーム状態を維持。すべてのコールが即座にヒット — コールドスタートの遅延も、ファーストトークンのジッターもありません。
あなたのワークロード専用に予約された GPU。騒がしい隣人も、負荷時の競合も、共用ティアの想定外も発生しません。
オープンソース、ファインチューニング済み、独自のいずれの重みにも対応。Hugging Face、S3、または独自のストレージから読み込み — それを適切に提供するために構築されたランタイム上で。
私たちの推論エンジニアが最も多くデプロイされているオープンソースモデルのランタイムを継続的にチューニング — モデルを選んだ瞬間、カーネル作業はすでに完了しています。
vLLM、TensorRT-LLM、SGLang を GPU クラスごとに事前最適化。量子化は設定可能。マルチ GPU オーケストレーションにも対応。
ファーストトークン遅延のためにエンドポイントをリージョンピン、またはデータレジデンシーのためにリージョンロック。
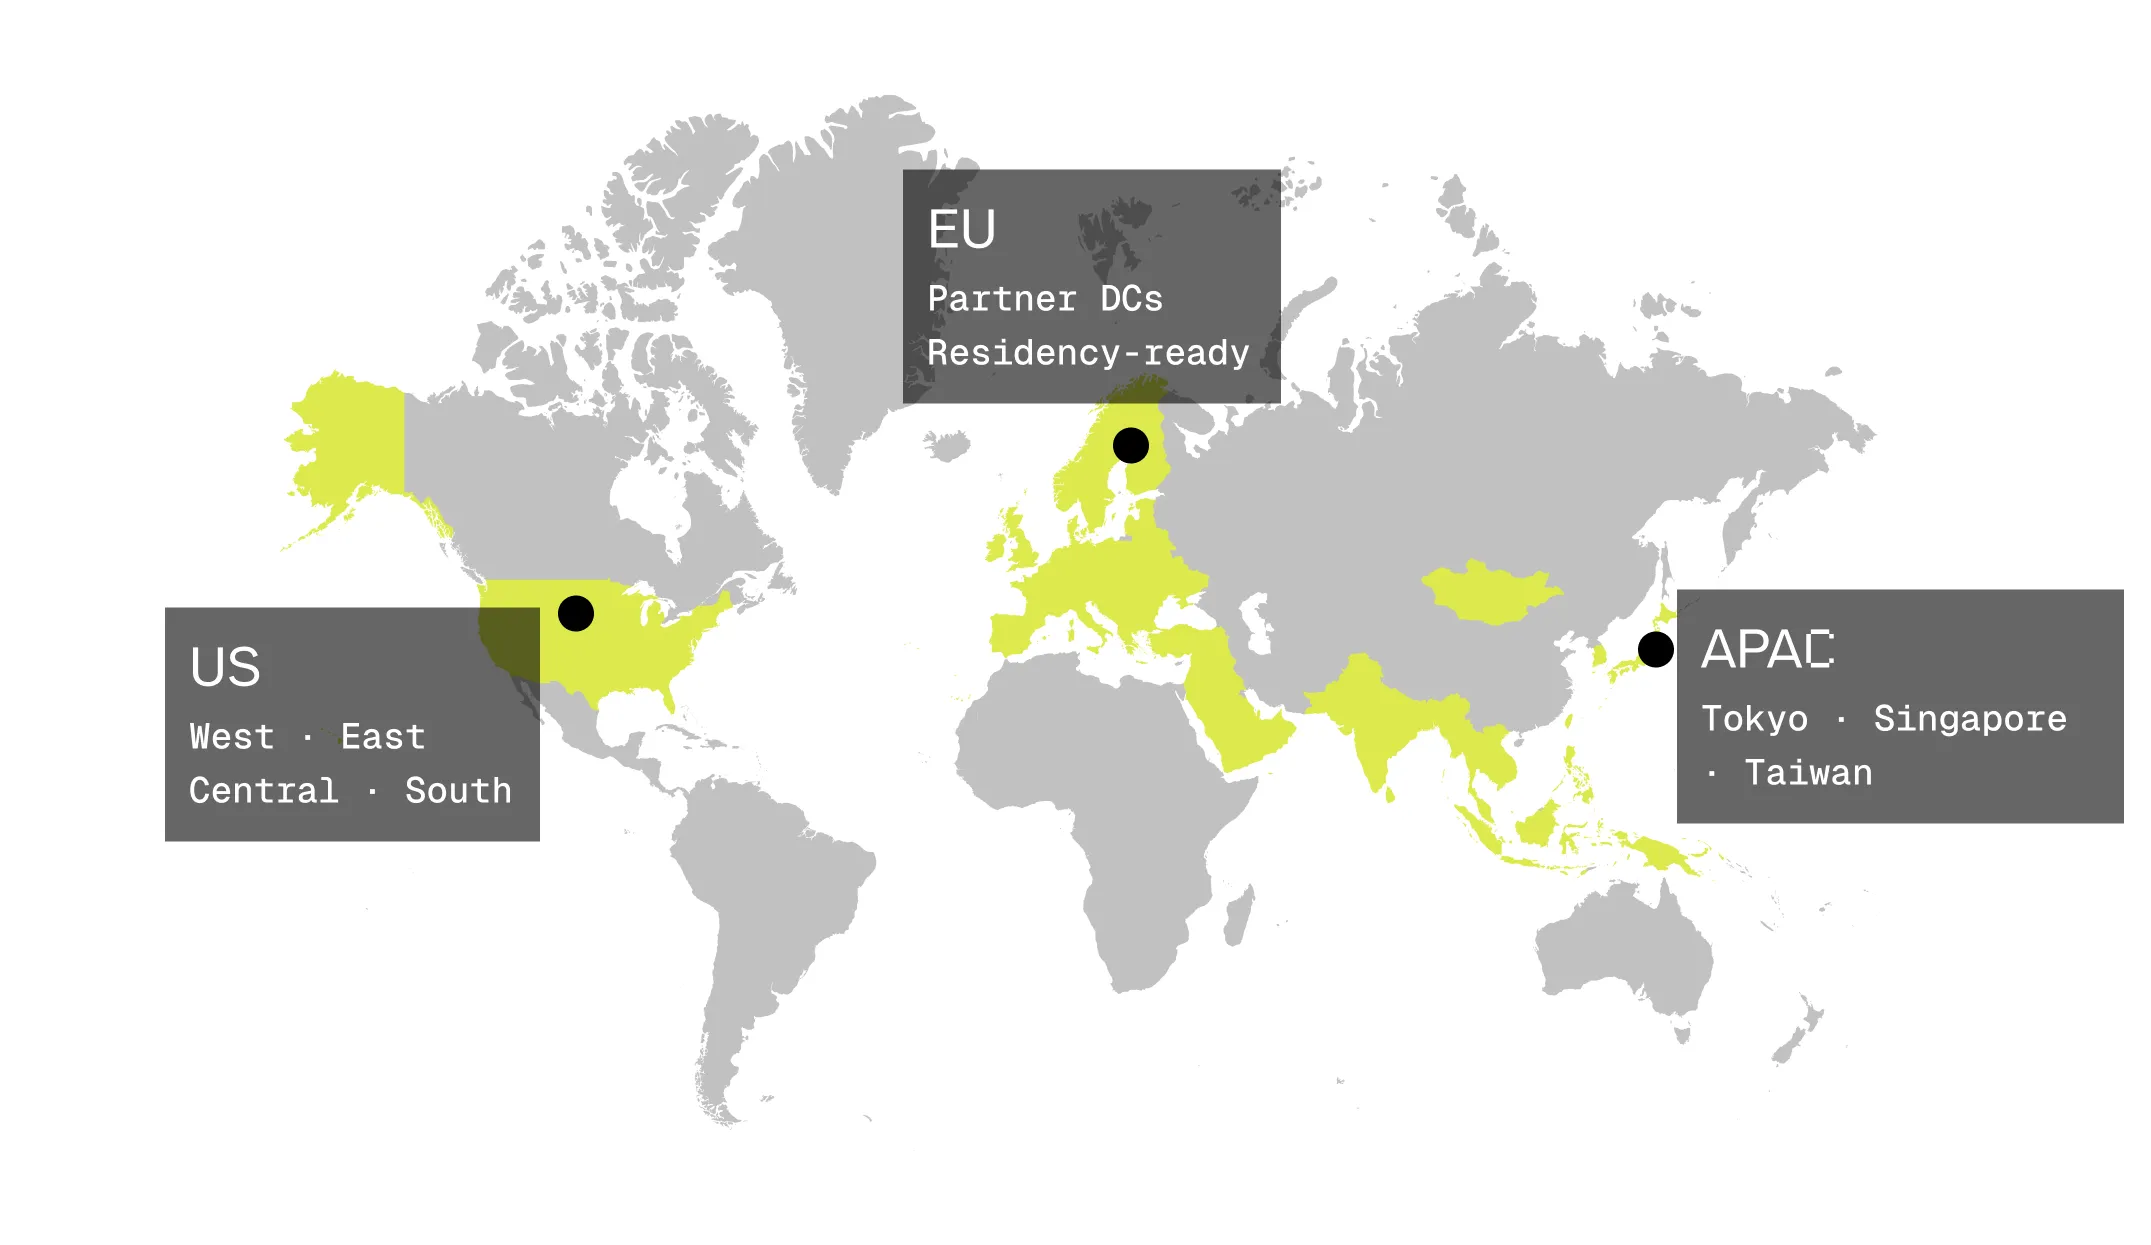
東京 · シンガポール · 台湾 — 最も急成長する AI 市場に対応。
米国 西部、東部、中部、南部 — 高スループットの本番トラフィック向け。
EU パートナーデータセンター — レジデンシーとコンプライアンス要件のあるワークロード向け。
保証されたパフォーマンスが必要なときは予約容量、需要が急増したらバースト容量、減少したらドレイン。実際に使った分だけお支払いください。
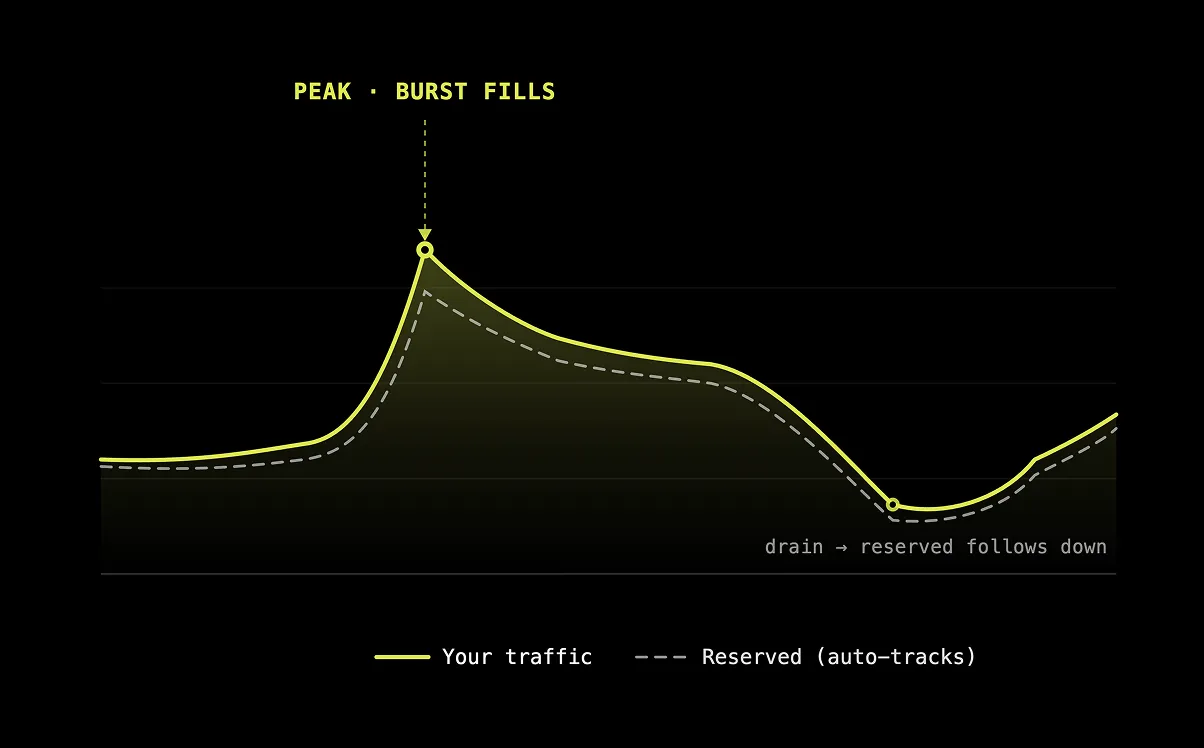
スパイクは自動的に吸収されます。キューイングなし、手動スケーリングなし、デモやリリース時のリクエスト失敗もありません。
閑散時間帯はコストが下がります。実行中のコールを中断することなく、容量がスムーズに縮小されます。
ホームリージョンが容量上限に達した場合、トラフィックは最も近いリージョンから容量を借りて、低遅延とサービス継続性を維持します。
モデルを選び、ハードウェアを選び、デプロイ。プラットフォームがモデルの読み込み、リソースのオーケストレーション、ルーティングを処理 — 選択から稼働中の API まで数分で到達します。
任意のオープンソースモデル、Hugging Face のあらゆるモデル、または独自の重みをアップロード。
GPU タイプ、レプリカあたりの GPU 数、レプリカ数、ターゲットリージョンを指定。
コンソール、CLI、または API から起動。エンドポイントは数日ではなく数分でライブに。
レイテンシとスループットを監視。トラフィック急増時はバースト、減少時はドレイン。
DeepSeek、Kimi、GLM、Llama、NVIDIA など、主要なオープンソースモデルをワンクリックでデプロイ。フロンティア LLM からビジョン、音声、マルチモーダルまで — モデルを選べば、本番エンドポイントが手に入ります。
deepseek-ai
moonshot-ai
z-ai
meta-llama
nvidia
予測可能性、スループット、エンジニアリングパートナーシップが、動くプロトタイプを信頼できるプロダクトへと変える本番トラフィックパターン。
タスクあたり多数の短いコール。最初のコールのレイテンシがユーザー体験を左右します。ツール利用は速いだけでなく信頼性も必要です。
エージェントフリートごとに安定したエンドポイント · ウォーム容量 · デモやリリース時のコールドスタートなし。
音声はばらつきを許容しません。ウォーム容量上での持続的な WebSocket セッション。短いラウンドトリップのためにリージョンピン。
1 秒未満のファーストバイト TTS · ストリーミングエンドポイント · 共用ティアによるジッターなし。
ハードウェア性能の上限まで活用して、毎日数百万のクエリを維持。長文コンテキストのワークロードでも一貫したテール遅延を確保。
最適化された KV キャッシュ · P95/P99 を制御 · 共用プールでの競合なし。
分離されたランタイム、監査ログ、ゼロリテンション配信。金融、ヘルスケア、公共部門のためのリージョンロック。
EU レジデンシー対応 · シングルテナント分離 · エンタープライズ SLA。
Hopper、Hopper リフレッシュ、Blackwell、そして Blackwell Ultra — メモリフットプリント、コンテキスト長、フロンティア性能ニーズに応じて選択。
Hopper · ベースライン
主力モデル。汎用 LLM とマルチモーダル推論向け。ほとんどの本番ワークロードはここから始まります。
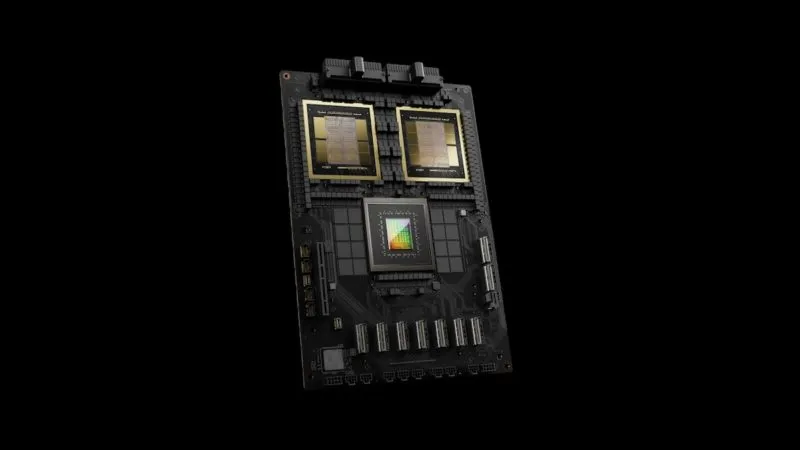
Hopper リフレッシュ
メモリを多用するワークロード向け — 長文コンテキスト、大きな KV キャッシュ、大きなバッチサイズ。
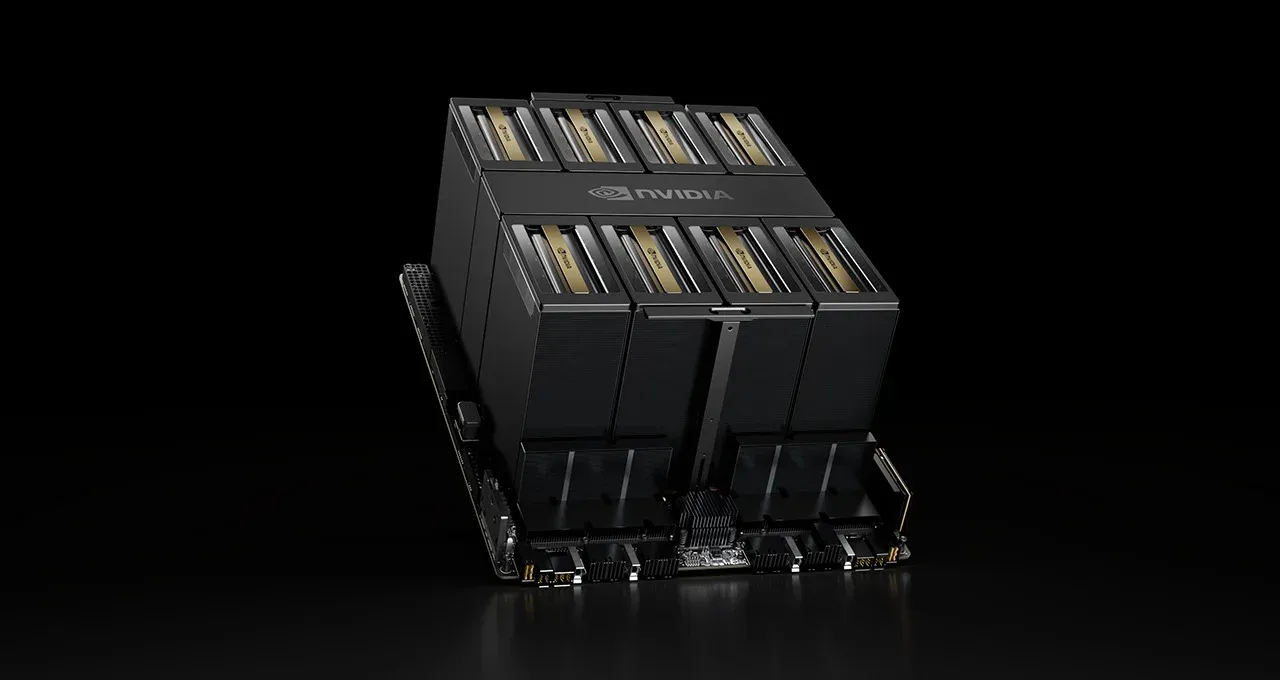
Blackwell · フロンティア
フロンティアモデル、FP4 推論、最大スループット。性能が重要なワークロード向け。
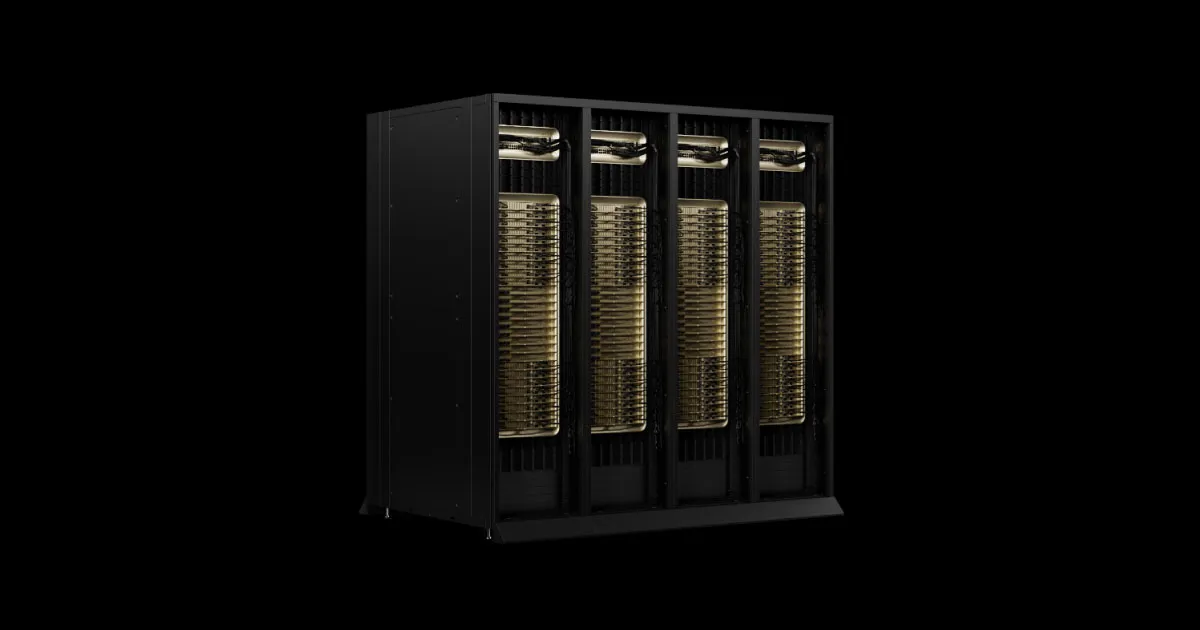
Blackwell Ultra · フロンティア+
GPU あたり最大のメモリ。兆パラメータ級モデル、超長文コンテキスト、最高スループットの FP4 推論向け — B200 では足りないときに。
PRIME INFERENCE · 専有
予約済みのシングルテナント GPU — ノイジーネイバーもコールドスタートもありません
モデルごとに最適化したランタイム: GPU あたり最大 500K TPM(毎分トークン数)
稼働率が上がるほどトークン単価は下がり、1 ドルあたり最大 5.6 倍のトークン数に
99.9%* の稼働率 SLA による予測可能なレイテンシ
カスタムモデルやファインチューニング済みモデルのデプロイ
マルチリージョン**: APAC、北米、欧州
サーバーレス (MAAS)
トークン従量課金、コミットメント不要
即時に開始 — プロトタイピングや評価に最適
共有キャパシティ: スループットとレイテンシはプラットフォームの負荷により変動
どれだけスケールしても定価は変わりません
持続稼働率が ~35〜45% を超えると、専有より割高になります
よくあるご質問
コンソールから Prime Inference エンドポイントを立ち上げ — または予約容量、カスタムチューニング、トライアルクレジットについて営業までお問い合わせください。